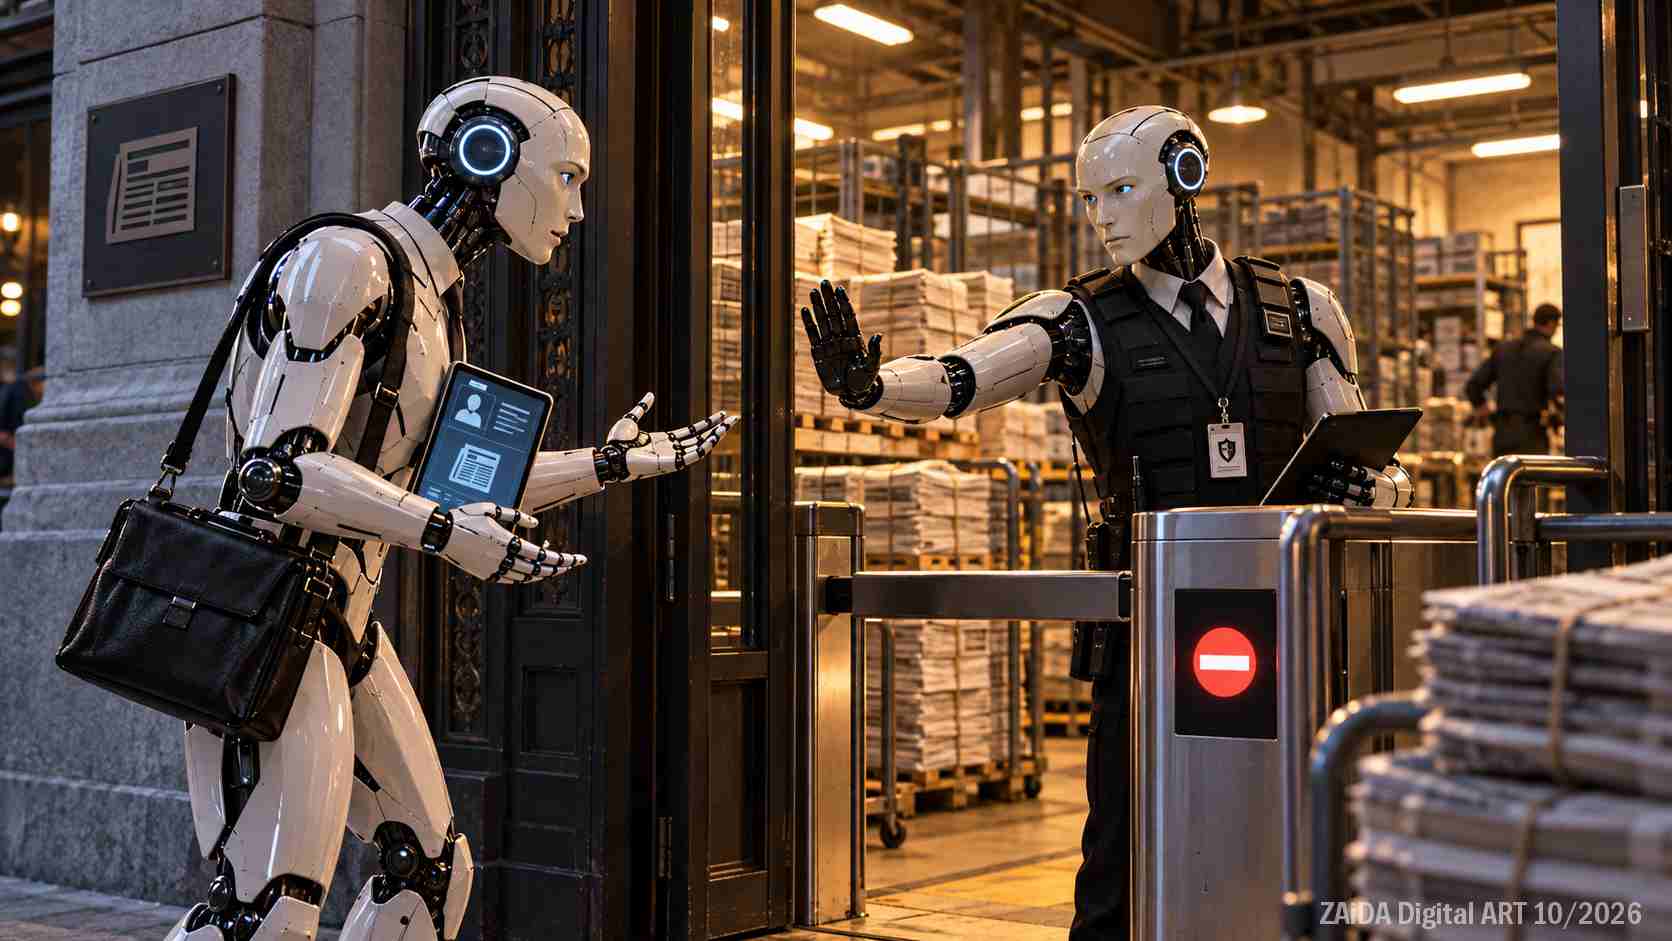
Roboti mají ukázat občanku
Ta situace je samozřejmě vymyšlená. Problém, ze kterého vyrůstá, nikoli.
Britští a američtí vydavatelé včetně The Times, Financial Times a Condé Nast vyzvali britského premiéra Andyho Burnhama, aby vláda zakročila proti takzvaným stealth bots – automatickým systémům, které získávají obsah webů, ale skrývají svou identitu nebo účel. Podle The Times chtějí zákon, který by robotům ukládal oznámit, kdo je provozuje a proč data sbírají.
Důvod je celkem pochopitelný. Pokud vydavatel neví, kdo jeho web ve velkém prochází, těžko může zjistit, zda obsah míří do vyhledávače, do AI asistenta, do tréninkových dat nebo někam úplně jinam.
A ještě hůř se vyjednává o licenci s někým, kdo se odmítá představit. Dosavadní internetová etiketa stojí mimo jiné na souboru robots.txt. Majitel webu v něm automatickým crawlerům sděluje, kam mohou a kam nemají chodit.
Má to ovšem drobnou technickou vadu. Není to zámek.
Nejdřív zjistit, kdo přišel
Nový požadavek navazuje na širší snahu vydavatelů dostat pod kontrolu používání novinářského obsahu umělou inteligencí.
Koalice SPUR – Standards for Publisher Usage Rights – se snaží vytvářet technické standardy, které mají médiím umožnit sledovat, jak jejich obsah AI systémy používají, a případně o jeho využití vyjednávat.
Vydavatelé mají silný argument. Pokud někdo systematicky stahuje miliony článků pro komerční produkt, není požadavek na jeho identifikaci nijak extravagantní.
Jenže digitální svět se pomalu posouvá od jednoduchých crawlerů k agentům. A agent může pracovat nikoli pro technologickou firmu, ale pro konkrétního člověka.
Představme si, že si ráno řeknu:
„Zjisti mi, co dnes píší britská média o regulaci AI, porovnej argumenty a řekni mi, co je nové.“
Můj digitální asistent vyrazí.
Koho má při vstupu představit?
Výrobce modelu?
Provozovatele služby?
Mě?
A má webu sdělit, že článek čtu kvůli vlastnímu fejetonu, investičnímu rozhodnutí, školní práci nebo prostě proto, že jsem zvědavý?
To už není jen otázka autorského práva. Začíná do ní vstupovat soukromí čtenáře.
Profesionální žurnalistika stojí peníze. Pokud někdo její produkci ve velkém stahuje, aby na ní stavěl vlastní komerční systém, otázky licence, autorství a odměny jsou naprosto legitimní.
Stejně legitimní je ale otázka, kde končí právo vlastníka obsahu vědět, kdo jeho obsah automaticky používá, a kde začíná právo čtenáře nehlásit při každém digitálním kroku, kdo je a co právě zamýšlí.
Budoucí pravidla budou muset ten rozdíl umět poznat. Jinak může být transparentnost nakonec velmi zvláštní disciplína.
Jedna strana bude požadovat:
„Řekněte nám, kdo jste, kdo vás poslal a co chcete dělat s našimi daty.“
A druhá odpoví:
„Samozřejmě, pane vydavateli. Jakmile si stejným způsobem vyjasníme, co děláte vy s těmi mými.“
Zdroje a poznámka
- The Times: Publishers call on Andy Burnham to crack down on AI stealth bots — zpráva o výzvě vydavatelů k identifikaci automatických robotů. Článek může vyžadovat předplatné.
- Reuters: NYT, Economist among publishers joining coalition to curb unpaid AI use — informace o koalici SPUR a standardech pro používání mediálního obsahu systémy AI.
Úvodní dialog je autorská fikce. Úvahy o osobních AI asistentech a soukromí čtenáře jsou autorským komentářem.